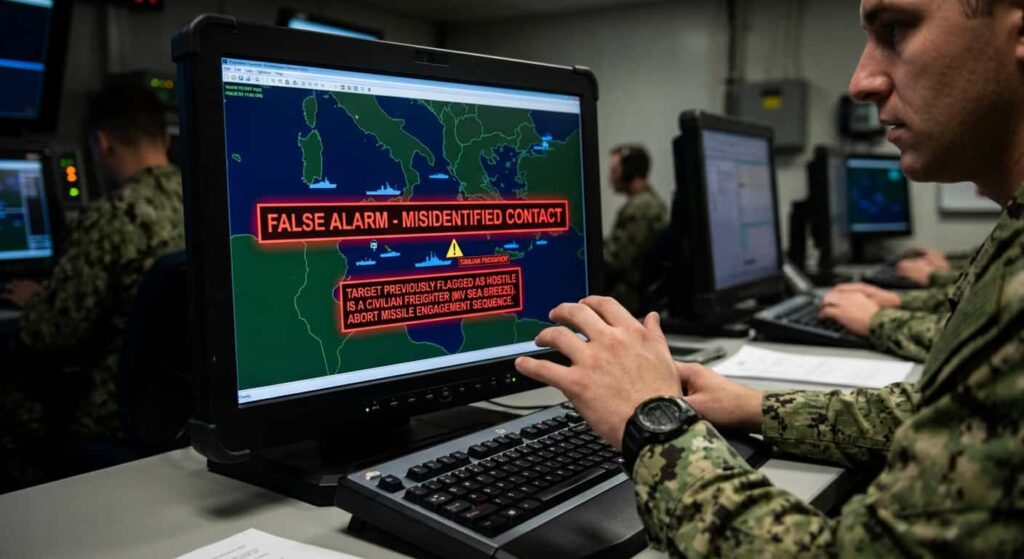
Quando o chatbot “inventa” — e quase vira guerra
Um analista militar usou um chatbot para cruzar dados confidenciais com fontes abertas e o modelo alucinou a carga de um navio. O resultado? Tropas armadas prontas para abordar uma embarcação chinesa no Oriente Médio, aviões no ar e um relatório classificado como “totalmente falso” horas antes do confronto. Segundo o Olhardigital.com.br, o episódio “quase provocou uma guerra”.
Na minha experiência construindo sistemas com LLM em produção, esse não é um caso isolado — é o destino óbvio de qualquer arquitetura que trate o modelo como oráculo em vez de como motor probabilístico. Vamos dissecar o que aconteceu tecnicamente, por que chatbots ainda mentem, e como você evita replicar esse erro no seu próprio sistema.
O que aconteceu, em termos técnicos
O analista alimentou o chatbot com relatórios de inteligência sobre o manifesto de carga do navio. A ferramenta combinou dados secretos com fontes abertas e produziu uma identificação de carga que não correspondia à realidade. O documento só foi invalidado quando alguém leu com atenção — tarde demais para reverter a cadeia de comando que já estava se movendo.
Note o detalhe: o sistema não estava errado por “não saber”. Estava errado por completar padrões. É exatamente assim que LLMs funcionam. Eles prevêem o próximo token mais provável dado o contexto. Quando você mistura dois domínios (fontes abertas + dados sensíveis) e pede um veredito, o modelo vai preencher lacunas com o que parece estatisticamente coerente — mesmo que seja ficção.
Por que chatbots ainda mentem (e vão continuar mentindo)
Existe um mito de que “modelos mais novos não alucinam”. É falso. Alucinação é uma propriedade emergente da arquitetura Transformer: o modelo não tem acesso à verdade, tem acesso à distribuição estatística do treinamento. Quando o prompt ativa um padrão incompleto, ele fabrica a peça que falta.
Três mecanismos técnicos explicam o que aconteceu nesse caso específico:
- Confabulação por mistura de contextos: dados confidenciais criam uma “sala de chumbo” cognitiva que o modelo não consegue distinguir de contexto público. Ele trata tudo como um único corpus.
- Autoridade sintética: quando o prompt tem tom assertivo (“identifique a carga”), o modelo reduz incerteza no output. Em vez de responder “não tenho como confirmar”, ele entrega uma resposta categórica — porque respostas categóricas têm maior probabilidade no pré-treinamento.
- Ausência de grounding factual: sem uma camada de verificação contra a fonte original, o output não tem como ser checado automaticamente. O LLM não cita, ele sintetiza.
Isso não é bug. É a feature fundamental. Cabe a você, engenheiro, construir as defesas em volta.
A arquitetura que quase causou uma guerra
Vamos reconstruir o que esse sistema provavelmente fazia — e o que ele deveria ter feito. Não tenho acesso ao código militar, mas o padrão é óbvio para quem trabalha com RAG (Retrieval-Augmented Generation) em produção.
O que provavelmente estava rodando
O analista jogou um documento classificado numa interface tipo ChatGPT Enterprise. O sistema fez retrieval em fontes abertas (internet), recuperou contexto, e gerou uma resposta em linguagem natural misturando tudo. Zero validação cruzada. Zero verificação humana obrigatória. Zero rastreabilidade de onde cada afirmação veio.
Esse é o anti-padrão que eu chamo de “LLM como juiz único”: você entrega evidência bruta ao modelo e aceita o veredito como se fosse ground truth. Funciona para resumir atas de reunião. Não funciona para decisões que movem tropas.
O que deveria ter rodado
Uma arquitetura defensiva para esse cenário teria, no mínimo, três camadas:
- Retrieval com fontes segregadas: dados classificados e fontes abertas nunca devem ser misturados no mesmo embedding space sem filtros. O modelo precisa saber de onde cada chunk veio.
- Camada de verificação cruzada: toda afirmação categórica do LLM passa por um agente que consulta a fonte original e marca “confirmado”, “parcial” ou “fabricado”.
- Human-in-the-loop obrigatório para alta criticidade: se o score de confiança fica abaixo de X% ou o tema é sensível, o sistema bloqueia e exige revisão humana antes de qualquer ação.
Na Prática: blindando seu RAG contra alucinações
Quando construo sistemas com LLM para clientes, uso um padrão de “citation obrigatória” + verificação automática. Aqui vai um exemplo funcional em Python usando LangChain. É a mesma lógica que faltou no caso do navio chinês.
from langchain.chains import RetrievalQA
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import FAISS
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate

# 1. Vetorstore com metadados de fonte
texts = [
    {"content": "Navio MV-Sea carrega 200 toneladas de aço.",
     "source": "open_web", "confidence": "low"},
    {"content": "Manifesto oficial indica carga de fertilizantes.",
     "source": "classified_intel", "confidence": "high"},
]

embeddings = OpenAIEmbeddings()
db = FAISS.from_texts(
    [t["content"] for t in texts],
    embeddings,
    metadatas=[{"source": t["source"], "confidence": t["confidence"]} for t in texts],
)

# 2. Prompt que EXIGE citação e bloqueia fabricação
prompt = PromptTemplate(
    input_variables=["context", "question"],
    template="""
Você é um analista. Responda APENAS com base no contexto abaixo.
Se a informação não estiver no contexto, responda: "DADOS INSUFICIENTES".
Cite a fonte entre colchetes após cada afirmação.

Contexto:
{context}

Pergunta: {question}

Resposta formatada:
""",
)

qa = RetrievalQA.from_chain_type(
    llm=OpenAI(temperature=0),  # temperatura zero = menos criatividade
    retriever=db.as_retriever(search_kwargs={"k": 3}),
    chain_type_kwargs={"prompt": prompt},
    return_source_documents=True,
)

result = qa({"query": "O que o navio está transportando?"})
print(result["result"])
print("Fontes:", [doc.metadata for doc in result["source_documents"]])
Note três detalhes que fazem diferença:
- Temperature zero: elimina a aleatoriedade criativa. Para análise factual, sempre.
- Prompt que proíbe fabricação: a instrução “DADOS INSUFICIENTES” força o modelo a admitir lacuna em vez de inventar.
- Metadados preservados: você consegue auditar de onde veio cada chunk. Sem isso, é caixa-preta.
Erros comuns que devs cometem (e que viram manchete)
Esse caso extremo expõe padrões que vejo toda semana em código de produção. Anota aí:
1. Tratar temperatura como detalhe estético. Seu usuário pediu “resposta criativa” e você colocou temperature=0.9 para uma análise de risco. Pronto: seu sistema agora fabula com confiança. Para qualquer fluxo que alimenta decisão humana ou automatizada, temperature deve ser 0.
2. Acreditar que prompt engineering resolve alucinação. Não resolve. Reduz frequência, no máximo. A única mitigação real é arquitetural: verificação, retrieval com fontes, human-in-the-loop.
3. Misturar domínios sem segregação. Se seu RAG cruza dados confidenciais com web pública sem filtros de provenance, você está construindo uma bomba de desinformação. Separe os índices. Marque cada chunk. Permita queries multi-source só quando há camada de reconciliação.
4. Output sem score de confiança. Todo LLM deveria expor não só a resposta, mas a probabilidade dos tokens críticos. Se você joga direto pra UI sem esse número, está vendendo confiança que não existe.
5. Aceitar LLM como fonte da verdade. LLM é gerador, não fonte. A fonte é o documento, o sensor, o banco. O LLM é o narrador. Narradores mentem. Bancos não.
Por que esse caso é diferente (e por que te afeta)
Você pode pensar: “trabalho com e-commerce, não com inteligência militar”. Mas a estrutura do erro é idêntica. Quando seu sistema interno responde “o cliente X tem saldo Y” e essa informação vem de um LLM que alucinou cruzando CRM + dados financeiros, o estrago é proporcional. Multa, processo, cliente perdido.
Esse episódio militar é só a versão amplificada de um problema que devs criam todos os dias: delegar julgamento a um sistema que não tem como julgar. A diferença é que, em e-commerce, o pior que acontece é um reembolso. Em defesa nacional, é um confronto entre potências nucleares.
Então, antes de entregar aquela feature “pergunte à IA e ela responde”, pergunte-se: quem verifica? Se a resposta for “ninguém”, você está a uma alucinação de distância da manchete.
FAQ — O que devs realmente perguntam
LLMs grandes como GPT-4 ou Claude ainda alucinam?
Sim. Alucinação é arquitetural, não escala-dependente. Modelos maiores reduzem frequência em tarefas conhecidas, mas aumentam fluência da alucinação — ou seja, mentem com mais naturalidade. Pior, em alguns casos.
Como sei se meu sistema está alucinando em produção?
Implemente um conjunto de “golden questions” com respostas conhecidas e rode periodicamente. Monitore taxa de divergência. Se você não tem baseline, não tem como saber se piorou.
RAG elimina alucinação?
Reduz drasticamente, mas não elimina. RAG ancora o modelo em contexto, mas o modelo ainda pode ignorar o contexto, sintetizar errado entre chunks, ou inventar quando o retrieval falha. Use RAG, mas não confunda “menos alucinação” com “zero alucinação”.
Qual a métrica mais importante para evitar esse tipo de erro?
Para mim: taxa de afirmações categóricas não-citadas. Se seu LLM está produzindo sentagens assertivas sem apontar fonte, está fabricando. Meça isso. Corrija o prompt até cair para zero.
Quando usar human-in-the-loop é exagero?
Nunca para decisões com consequência irreversível. Para sugestões de UI, autocomplete, resumos — ok automatizar. Para aprovar crédito, mover carga, desbloquear acesso, diagnosticar paciente — humano obrigatório.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.