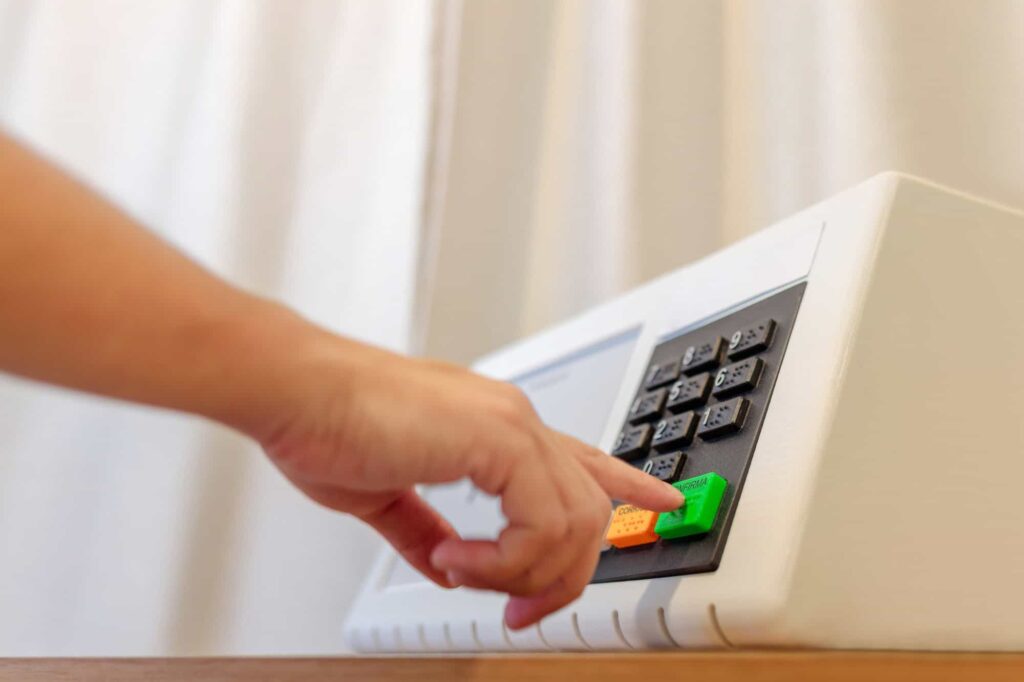
>A eleição de 2026 no Brasil não é só um evento político — é o maior teste de estresse em produção que a OpenAI já enfrentou em um cenário de democracia real. Segundo o Olhardigital.com.br, Bruno Lewicki, head de políticas públicas da OpenAI na América Latina, afirmou que o país servirá como laboratório para outros pleitos que acontecerão no ano seguinte. Na minha leitura, isso é muito mais significativo do que parece à primeira vista: pela primeira vez, temos uma big tech de IA operando em escala massiva em um ambiente regulatório novo, com regras do TSE que ainda não têm jurisprudência firmada. E isso muda o jogo para quem desenvolve.
Por que o Brasil é diferente de qualquer outro mercado para a OpenAI
Quando li a entrevista original, publicada originalmente no podcast A Máquina (Folha de S.Paulo), três números me chamaram atenção. O primeiro: 215 milhões de mensagens diárias ao ChatGPT vindas do Brasil. Isso coloca o país entre os maiores usuários globais do produto. O segundo: a velocidade com que o TSE aprovou resoluções específicas para IA generativa — algo que a Europa ainda está finalizando com o AI Act. O terceiro: a ausência de jurisprudência, que significa que qualquer incidente será precedente.
Na minha experiência com sistemas em produção, quando você combina alta volumetria, regulação nova e precedente zero, o resultado é sempre o mesmo: você aprende mais em seis meses do que em dois anos de operação estável. É isso que está acontecendo agora.
As três frentes da OpenAI e o que cada uma significa no código
1. Transparência via metadados e marca d’água invisível
Segundo Lewicki, imagens geradas pelo DALL-E recebem uma etiqueta digital com metadados de origem e uma marca d’água invisível. Isso não é improvisado — é a implementação do padrão C2PA (Coalition for Content Provenance and Authenticity), um consórcio que inclui Adobe, Microsoft, BBC, Intel e a própria OpenAI. O C2PA manifests criptográficos assinados dentro do arquivo da imagem, criando uma cadeia de custódia verificável.
O caso que Lewicki citou é revelador: uma jornalista de agência de checagem usou a ferramenta pública da OpenAI para identificar que um suposto relatório da Polícia Federal circulando em redes sociais havia sido gerado por IA. Isso só foi possível porque o arquivo carregava o manifesto C2PA intacto. Quando alguém exporta a imagem via screenshot, recodifica em JPEG com compressão agressiva ou recorta — a cadeia se quebra.
2. Grounding em fontes oficiais durante o período eleitoral
A segunda frente é a priorização de fontes. Durante o pleito, o sistema passa a dar peso maior a URLs do TSE e de veículos jornalísticos na composição das respostas. Tecnicamente, isso opera na camada de retrieval-augmented generation (RAG) — o modelo consulta um índice atualizado e injeta os resultados no contexto antes de gerar a resposta.
Para quem trabalha com RAG, vale entender que essa “filtragem de fontes” não é uma bala de prata. Ela reduz a probabilidade de alucinação factual sobre datas, locais e regras, mas não elimina o risco de interpretação enviesada de uma manchete fora de contexto. É mitigação, não solução.
3. Monitoramento contínuo por equipes de segurança
A terceira frente é a mais clássica: abuse detection. Equipes de trust & safety operam em ciclos de revisão, ajustando classificadores internos e atuando em casos reportados. Nada revolutionary aqui — é o que toda plataforma madura faz. O ponto interessante é que, no Brasil, esse monitoramento está sendo calibrado em tempo real com a proximidade do pleito.
Na Prática: como extrair e validar metadados C2PA de uma imagem
Se você trabalha com conteúdo gerado por usuário, moderação ou compliance, vai precisar entender como ler esses manifests. Aqui vai um exemplo funcional em Python usando a biblioteca pyvips para inspecionar os metadados C2PA de uma imagem:
"""
Verificador de proveniência C2PA para imagens.
Uso: python check_c2pa.py caminho/para/imagem.jpg
"""

import sys
import json
import pyvips

def extract_c2pa_manifest(image_path: str) -> dict:
 """Extrai o manifesto C2PA embutido nos metadados XMP da imagem."""
 try:
 image = pyvips.Image.new_from_file(image_path, access="sequential")
 except Exception as e:
 return {"error": f"Falha ao abrir imagem: {e}"}

 # C2PA armazena os dados em campos XMP customizados
 raw_metadata = image.get("image-description")
 xmp_metadata = image.get("xmp-data")

 result = {
 "file": image_path,
 "has_c2pa": False,
 "generator": None,
 "signed_at": None,
 "manifest_chain": [],
 }

 if xmp_metadata:
 # Procura pelo namespace C2PA nos blocos XMP
 for field in xmp_metadata.split("\n"):
 if "c2pa" in field.lower():
 result["has_c2pa"] = True
 result["manifest_chain"].append(field.strip())

 return result


def detect_ai_artifacts(image_path: str) -> dict:
 """Heurística adicional: detecta inconsistências comuns em IA."""
 image = pyvips.Image.new_from_file(image_path)

 # Diferença entre canais RGB — IA generativa tende a ter
 # correlação anômala entre canais em regiões sintéticas
 r, g, b = image[0], image[1], image[2]
 rg_diff = (r - g).abs().avg()
 rb_diff = (r - b).abs().avg()

 return {
 "rg_channel_diff": float(rg_diff),
 "rb_channel_diff": float(rb_diff),
 "warning": "Diferença < 2.0 pode indicar geração por IA"
 if min(float(rg_diff), float(rb_diff)) < 2.0
 else None,
 }


if __name__ == "__main__":
 if len(sys.argv) < 2:
 print("Uso: python check_c2pa.py <caminho_da_imagem>")
 sys.exit(1)

 manifest = extract_c2pa_manifest(sys.argv[1])
 artifacts = detect_ai_artifacts(sys.argv[1])

 print(json.dumps({"manifest": manifest, "artifacts": artifacts},
 indent=2, ensure_ascii=False))
Esse script não é uma bala de prata — heurísticas de canal RGB são indicativas, não conclusivas. Para verificação confiável, use a ferramenta oficial do Content Credentials ou a API da OpenAI que a jornalista do caso mencionado usou. Mas em pipelines próprios, ter uma camada local de triagem economiza banda e tempo de resposta.
Implicações práticas para quem desenvolve
Se você roda qualquer produto que aceita, processa ou exibe conteúdo gerado por usuário, três coisas mudam a partir de agora:
- Logs e auditoria ficam obrigatórios. Se sua plataforma hospeda mídia, você precisa ser capaz de responder “essa imagem foi gerada por IA?” em segundos, não em horas.
- RAG exige curadoria contínua de fontes. Se você usa GPT ou qualquer LLM para responder perguntas factuais, o índice de retrieval precisa ser revisado em ciclos curtos durante eventos críticos. Referências obsoletas viram desinformação amplificada.
- UX precisa expor proveniência. Esconder se um conteúdo é sintético é risco legal crescente. Exibir um selo “verificado por C2PA” ou “gerado por IA” já é expectativa, não diferencial.
Erros comuns que devs cometem nesse cenário
Já revisei código de times lidando com isso. Os tropeços são sempre os mesmos:
- Confiar só no prompt para “não inventar dados”. Prompt engineering não substitui grounding em fontes verificadas. Se seu RAG aponta para um blog desatualizado, o modelo vai citar o blog desatualizado com confiança.
- Ignorar a cadeia de manifest. Verificar que existe metadado C2PA não basta. Você precisa validar a assinatura criptográfica contra o emissor. Manifest adulterado é vetor clássico de ataque.
- Tratar screenshot como imagem íntegra. Quando o usuário tira print, a cadeia C2PA morre. Seu sistema precisa estar preparado para sinalizar “provenance perdida” em vez de assumir conteúdo legítimo.
- Esquecer do canal de áudio e vídeo. A discussão toda gira em torno de imagem, mas deepfakes de áudio são o vetor que mais cresce em WhatsApp e Telegram no Brasil. Se você modera mídia, áudio é prioridade.
- Subestimar o volume. 215 milhões de mensagens diárias é tráfego massivo. Qualquer ferramenta de detecção que você plugar no pipeline precisa ser assíncrona ou ter custo por chamada muito baixo. Do contrário, a fatura da API come a margem do produto.
O que falta resolver — minha leitura honesta
Lewicki admitiu que a ferramenta de detecção da OpenAI não funciona para texto, só para imagem e áudio. Isso é honesto, mas também é o calcanhar de Aquiles. Texto é o vetor mais barato e escalável de desinformação — custa zero gerar 10 mil tweets falsos por hora. A OpenAI não tem, hoje, watermark viável para texto. Trabalhos acadêmicos recentes (como o da Universidade de Maryland com “watermarks semânticos”) ainda estão longe de produção.
Para nós, devs, isso significa: não construa sistemas que dependam de detecção confiável de texto gerado por IA. Ainda não existe. Construa sistemas que dependam de contexto, fonte e reputação do emissor. É menos elegante, mas funciona hoje.
Perguntas que um dev faria (FAQ)
1. A ferramenta da OpenAI que detectou o relatório da PF é pública? Tem API?
Existe uma interface web onde você sobe imagem ou áudio e recebe o veredito. API pública e documentada para integração em pipeline ainda não foi liberada de forma estável até o momento. Para produção, a saída é raspar a interface ou usar a biblioteca c2pa-python da Adobe para validação local.
2. O padrão C2PA é aberto? Posso implementar do meu lado?
Sim, é especificação aberta mantida pela Adobe, Microsoft, Intel e OpenAI entre outros. A SDK oficial está em github.com/c2pa-org com bindings para C++, Python e Rust.
3. Se eu recorto uma imagem, perco a marca d’água invisível?
Depende. A marca d’água é estatística (perturba pixels de forma controlada), então tecnicamente sobrevive a recortes. Mas o manifesto C2PA nos metadados XMP não sobrevive — ele é perdido em qualquer operação que reescreva o arquivo. Você fica com a marca, mas sem a cadeia de custódia verificável.
4. Como saber se um texto veio do ChatGPT?
Sem watermark confiável, a saída atual é análise estatística (perplexidade, burstiness, padrões de token) combinada com checagem de contexto. Ferramentas como GPTZero fazem isso com taxa de acerto razoável, mas longe de 100%. Não tome como verdade absoluta em nenhum pipeline crítico.
5. O TSE tem API oficial que devs podem consumir?
Sim. O TSE mantém o Divulga, portal de dados abertos com candidados, resultados e prestação de contas. Para dados em tempo real durante a eleição, há também o Resultados oficial. Integre isso como fonte primária em qualquer sistema que fale sobre pleito.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto — especialmente se você trabalha com moderação, RAG em produção ou compliance de IA.