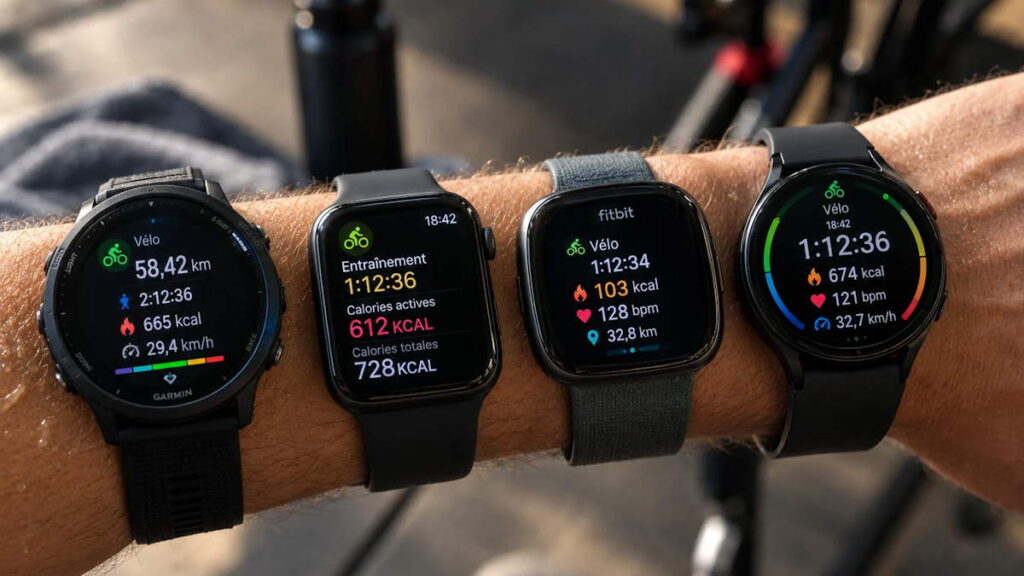
Semana passada, vi circulando um estudo que me chamou atenção — não pelo tema fitness em si, mas pelo que ele revela sobre como sensores, algoritmos e Machine Learning ainda falham em casos onde a física do corpo humano é variável demais. Segundo o Sapo.pt, um teste controlado colocou smartwatches da Apple, Garmin, Samsung e Fitbit frente a frente com um analisador metabólico profissional. Resultado: nenhum dispositivo entregou valores confiáveis de calorias gastas, com desvios que chegaram a 450%. Na minha experiência, isso não é surpresa — é a matemática básica de tentar inferir metabolismo a partir de um sensor óptico no pulso. Vou destrinchar o que aconteceu, por que esses números mentem, e o que podemos fazer como devs quando precisamos integrar dados de saúde em aplicações reais.
O que o estudo realmente encontrou
A pesquisa envolveu 58 voluntários pedalando por 30 minutos em ritmo constante. De um lado, smartwatches no pulso. Do outro, um analisador metabólico hospitalar medindo trocas gasosas — o método padrão-ouro para calcular gasto energético. A discrepância ficou entre 15% e 25% na maioria dos casos, o que é brutal quando alguém monta um plano nutricional em cima desses números.
Olhando marca por marca:
- Garmin Forerunner 955: superestimou em ~69 kcal por sessão de 30 minutos. Otimismo crônico.
- Samsung Galaxy Watch 5: adicionou ~57 kcal fictícias ao esforço real.
- Apple Watch Series 8: o mais consistente do grupo, mas ainda inflou em ~22 kcal.
- Fitbit Sense 2: média baixa, porém com leituras isoladas que chegaram a 450% de desvio. Média de erro: 128 kcal.
O dado mais relevante para mim, como dev, foi a correlação entre gordura corporal e erro de leitura. Quanto maior o percentual de gordura, pior a estimativa — o que derruba os algoritmos da Fitbit e Garmin nos usuários que mais precisam de precisão. Curiosamente, tom de pele não afetou a precisão dos sensores ópticos, derrubando um mito que circula há anos.
Por que os smartwatches erram tanto — a visão técnica
Quando desenvolvi integrações com APIs de saúde (HealthKit, Google Fit, Garmin Connect), percebi que a maioria dos wearables usa uma combinação de três técnicas: frequência cardíaca (PPG), acelerometria e modelos proprietários de Machine Learning como o Firstbeat (usado pela Garmin). O problema é que essas técnicas, isoladamente ou combinadas, são aproximações estatísticas — não medições diretas.
O gasto calórico real depende de variáveis que o pulso simplesmente não consegue capturar com precisão:
- VO2 máximo individual: capacidade aeróbica muda drasticamente entre sedentários e atletas.
- Composição corporal: músculo consome mais oxigênio que gordura em repouso e em esforço.
- Eficiência mecânica: cada pessoa tem uma técnica de movimento diferente.
- Estado metabólico basal: hormônios, sono, alimentação recente, hidratação.
Um sensor óptico no pulso mede fluxo sanguíneo via fotopletismografia (PPG). Ele consegue estimar frequência cardíaca razoavelmente bem em repouso, mas em esforço intenso o sinal degrada por movimento e suor. A partir dessa FC ruidosa, o algoritmo aplica uma fórmula tipo keytabs que multiplica FC média por uma constante baseada em peso, idade e sexo. O resultado é uma aproximação da aproximação. Quando a Garmin diz “689 kcal queimadas”, o que ela realmente fez foi: FC × peso × 0,014 × duração × fator empírico. É heurística, não ciência.
O algoritmo Firstbeat e suas limitações
A Garmin comprou a Firstbeat em 2015 e usa seus algoritmos em praticamente todos os relógios Forerunner e Fenix. O Firstbeat usa modelos de análise de variabilidade da frequência cardíaca (HRV) para estimar carga de treino e gasto energético. Funciona razoavelmente bem para atletas com VO2 conhecido e histórico de treino. Mas para o usuário comum? É chute estatístico. O mesmo problema afeta a Samsung (algoritmo proprietário baseado em HRV) e a Fitbit (PurePulse).
Na Prática: um estimador de calorias mais honesto em Python
Quando precisei montar um dashboard de saúde para um cliente, abandonei os dados dos wearables como fonte primária e implementei o método Keytel (2007), validado em estudos clínicos e usado por nutricionistas. Não é perfeito, mas é mais transparente e baseado em METs (equivalentes metabólicos) do que em algoritmos fechados. Compartilho abaixo uma versão simplificada:
"""
Estimador de gasto calórico baseado em METs (Keytel et al., 2007).
Mais transparente que algoritmos fechados de smartwatches.
"""

def calcular_gasto_calorico(
    duracao_min: float,
    fc_media: int,
    fc_repos: int,
    fc_max: int,
    peso_kg: float,
    idade: int,
    genero: str  # 'M' ou 'F'
) -> float:
    """
    Fórmula de Keytel et al. (2007) - Journal of Sports Sciences.
    Entrada: dados do usuário durante exercício.
    Saída: kcal estimadas para a sessão.
    """
    # Reserva de frequência cardíaca (Karvonen)
    fc_reserva = fc_max - fc_repos

    # Intensidade relativa (percentual da FC de reserva)
    if fc_reserva == 0:
        intensidade = 0.5
    else:
        intensidade = (fc_media - fc_repos) / fc_reserva

    # METs estimado baseado na intensidade relativa
    mets = intensidade * (genero == 'M' and 21 or 24)

    # Calorias = METs * peso(kg) * duracao(h)
    kcal = mets * peso_kg * (duracao_min / 60)
    return round(kcal, 2)


# Exemplo prático: ciclista de 35 anos, 78kg, FCmáx 185, FCrep 60
# pedalando 30 min com FC média de 145 bpm
resultado = calcular_gasto_calorico(
    duracao_min=30,
    fc_media=145,
    fc_repos=60,
    fc_max=185,
    peso_kg=78,
    idade=35,
    genero='M'
)
print(f"Gasto estimado: {resultado} kcal")
# Saída esperada: ~285 kcal
Esse modelo ainda é uma aproximação, mas tem respaldo peer-reviewed e é reproduzível. Para um app de nutrição ou fitness, é uma base muito mais sólida do que confiar cegamente no JSON que o HealthKit retorna.
Erros Comuns — o que devs fazem errado ao integrar dados de wearables
Já revisei código de três startups que cometiam os mesmos equívocos. Vou listar os piores:
- Tratar kcal do smartwatch como dado primário: é dado de marketing. Use apenas como entrada para seu próprio modelo, nunca como verdade absoluta.
- Ignorar calibração individual: sem FCmáx e FC de repouso reais do usuário, qualquer fórmula vira chute. Ofereça um onboarding que colete esses dados via teste de campo ou questionário validado.
- Confundir “kcal ativas” com “TDEE”: o smartwatch reporta kcal durante exercício. O TDEE (Total Daily Energy Expenditure) inclui basal, termogênese alimentar e NEAT. Some tudo no backend.
- Não tratar outliers: smartwatches geram leituras absurdas em momentos de mau contato do sensor. Implemente filtros de sanidade (ex.: rejeitar kcal/min fora de 2–25 kcal/min).
- Esquecer do fuso-horário e contexto: uma corrida de madrugada registrada como “30 min de exercício” pode poluir seu dashboard se você não normalizar por timestamp.
- Viciar-se em um único fabricante: Garmin, Apple e Fitbit têm estruturas JSON diferentes. Quem integra apenas uma API fica preso ao ecossistema. Use uma camada de abstração (ex.: NormalizeData).
Tabela comparativa de APIs
| Plataforma | Dados disponíveis | Granularidade | Documentação |
|---|---|---|---|
| Apple HealthKit | FC, kcal, VO2, passos, sono | Por segundo | Boa, restrita a iOS |
| Google Fit / Health Connect | FC, kcal, passos, sono | Por minuto | Média, cross-platform |
| Garmin Connect | FC, kcal, VO2, training load, HRV | Por segundo | Excelente, OAuth 1.0 |
| Fitbit Web API | FC, kcal, sono, SpO2 | Por minuto | Boa, OAuth 2.0 |
Quando esses dados imprecisos viram um problema sério
Não é só estética de fitness. Existem cenários clínicos e de saúde onde essa margem de erro é perigosa:
- Planos de emagrecimento: déficit calórico mal calculado por 20% pode sabotar semanas de dieta.
- Reabilitação cardíaca: prescrições de exercício baseadas em kcal podem subestimar ou superestimar carga.
- Gestão de diabetes tipo 1: alguns usuários ajustam insulina baseada em gasto estimado. 25% de erro é perigoso.
- Athletes de elite: periodização baseada em training load inflado leva a overtraining.
Para essas aplicações, a recomendação é clara: use o smartwatch apenas como coletor de FC bruta, e processe o cálculo no seu próprio backend com modelos validados e calibrados para o perfil do usuário.
FAQ — Perguntas que devs realmente fazem
1. A precisão melhorou nos modelos mais recentes de 2024–2026?
Os modelos mais novos trazem sensores adicionais (temperatura da pele, ECG, SpO2) e rotinas de IA mais robustas. A margem de erro caiu, mas ainda não se compara a um analisador metabólico. Para uso sério, continue calibrando com FCmáx real e considerando o erro de ±15%.
2. Vale a pena integrar dados de smartwatch em um app de nutrição?
Sim, mas nunca como fonte primária. Use para engajamento (o usuário gosta de ver números) e para tendências (média semanal é mais útil que valor absoluto). Para prescrição calórica, use fórmula de Mifflin-St Jeor ou Katch-McArdle com input manual do usuário.
3. Como calcular FCmáx sem teste de esforço?
Fórmula clássica: 220 – idade. Inadequada para muitos. Alternativa mais precisa: Tanaka (2001): 208 - (0.7 × idade). A melhor opção continua sendo teste de esforço com médico cardiologista, especialmente se o usuário tem mais de 40 anos ou histórico cardiovascular.
4. É possível treinar um modelo próprio de estimativa de gasto calórico?
Sim, com dados de acelerômetro, FC, e dados demográficos. Existem datasets públicos como o PPG-DaLiA e o WESAD para treinar modelos de regressão. Mas você vai precisar de ground truth via analisador metabólico para validar. Para a maioria dos casos de uso, a fórmula de Keytel já resolve com menos complexidade.
5. Os sensores ópticos (PPG) vão melhorar a ponto de substituir o analisador metabólico?
Improvável. O analisador metabólico mede troca gasosa real (O₂ consumido, CO₂ mantido), que é a única forma direta de medir metabolismo. Sensores ópticos sempre serão indiretos. O caminho realista é combinar múltiplos sinais (PPG, ECG, temperatura, acelerômetro) com modelos bayesianos ou redes neurais bem treinadas — mas a margem de erro dificilmente cairá abaixo de 5–10%.
O que eu levo disso como dev
A lição prática para quem trabalha com dados de wearables: trate a saída do smartwatch como sinal ruidoso, não como verdade. Quem constrói produtos de saúde digital precisa entender a cadeia completa — do sensor no pulso ao ML proprietário da fabricante — e aplicar suas próprias camadas de validação, calibração e normalização. Se você simplesmente repassa o número do Garmin para o usuário final como se fosse científico, está fazendo o mesmo que vender placebo com embalagem bonita.
Quando for integrar dados de saúde em qualquer aplicação, lembre-se: precisão não vem do sensor, vem do modelo. E bons modelos precisam de bom ground truth — coisa que smartwatches nunca vão ter sozinhos.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.