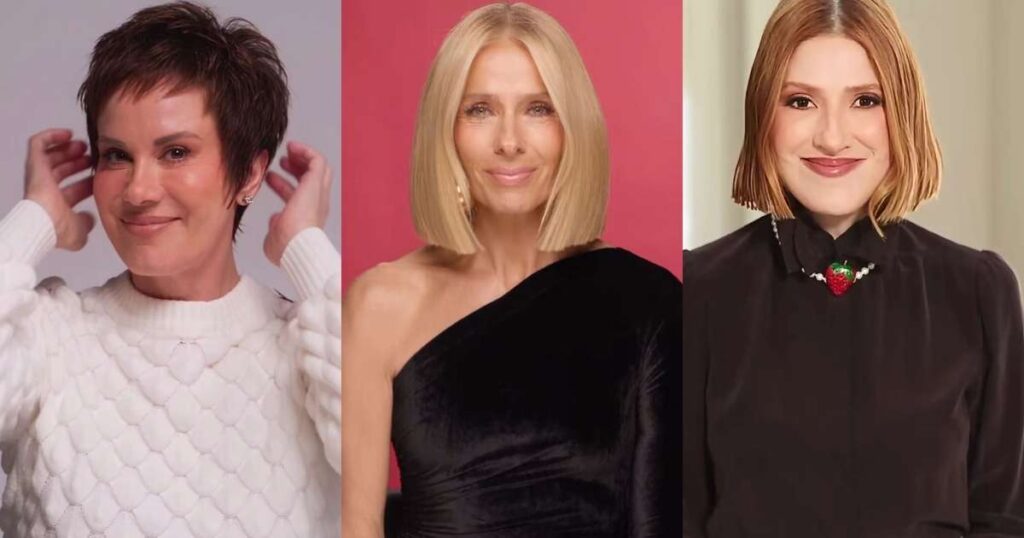
Vi metade do meu feed recortando cabelo virtual esta semana — Adriane Galisteu, Dani Calabresa, Brunna Gonçalves, Regina Volpato. Nenhuma delas foi ao salão. Segundo o Terra.com.br, todas usaram o mesmo tipo de filtro baseado em IA que simula um corte chanel a partir de uma única foto. Parece mágica. Não é. É engenharia de difusão com um pipeline muito bem montado, e é exatamente o tipo de coisa que devs de visão computacional e LLMs multimodais conseguem replicar — ou pelo menos entender de ponta a ponta. Vou destrinchar o que está por trás dessa trend e mostrar como você, dev, pode montar algo parecido.
Como o “filtro de corte de cabelo” realmente funciona
Não existe um único modelo chamado “HairCutFilter”. O que vemos no Instagram e no TikTok é uma cadeia de etapas — um pipeline clássico de generative AI. Na minha experiência montando demos com Stable Diffusion e derivados, o fluxo que entrega esse tipo de resultado segue, na maior parte das vezes, estes blocos:
- Detecção e segmentação do rosto e cabelo. Um modelo tipo MediaPipe Face Mesh, YOLO-Face ou BiSeNet identifica a região capilar e gera uma máscara. Sem máscara limpa, o resto do pipeline vira Frankenstein.
- Estimativa de pose e profundidade. Modelos como DepthFM ou o próprio ControlNet com mapas de profundidade garantem que o novo cabelo respeite a geometria da cabeça — ninguém quer um chanel flutuando dois centímetros acima da testa.
- Inpainting guiado. Aqui entra o modelo generativo. Stable Diffusion XL, Flux.1 ou um fine-tune específico para cabelo. A máscara é a área a ser “pintada”, e o prompt faz o resto.
- Refinamento de identidade. Para o rosto não mudar junto (o famoso “ficou outra pessoa”), entra um passo de face restoration com CodeFormer ou GFPGAN, preservando os traços da celebridade.
O resultado é fotorrealista porque cada etapa cobre a fraqueza da anterior. Quem tenta pular a segmentação ou usar apenas um prompt em um modelo base trava logo no primeiro teste.
Por que ficou tão convincente agora (e não há 2 anos)
Quando testei os primeiros pipelines de inpainting em 2023, o cabelo saía borrado, com textura de plástico, e quase sempre mudava o formato do rosto. Três coisas mudaram desde então:
- Modelos base mais fortes. Flux.1 e SDXL-Turbo geraram um salto de coerência espacial absurdo. O cabelo “respira” dentro da imagem em vez de parecer colado.
- LoRAs e adapters especializados. Treinar um LoRA com algumas dezenas de fotos de um corte específico virou commodity. A comunidade do Civitai tem modelos de “bob cut”, “pixie”, “buzz cut” prontos para baixar.
- ControlNet multi-condicional. Combinar depth + canny + máscara no mesmo pipeline dá o controle fino que faltava. Antes era “sorteio criativo”, hoje é direção de arte.
Comparativo: as ferramentas que entregam esse tipo de resultado
| Ferramenta | Tipo | Qualidade visual | Controle do dev |
|---|---|---|---|
| Stable Diffusion + ControlNet | Open source, self-hosted | Alta (com LoRA bom) | Total |
| Flux.1 (Black Forest Labs) | Open weights | Muito alta | Total |
| Midjourney v6 | API/Discord | Excelente | Médio (limitado a inpainting básico) |
| DALL·E 3 (edit) | API OpenAI | Boa, mas menos consistente | Baixo |
| Apps mobile (Filter, FaceApp etc.) | Closed source | Ótima para viralizar | Zero (é caixa-preta) |
| Hugging Face Diffusers + IP-Adapter | Open source | Alta, com fine-tuning | Total |
Para uma trend viral de uma semana, o caminho rápido é um app mobile. Para um produto real ou um estudo sério, a stack open source ganha em controle, custo e auditabilidade.
Na Prática: montando um pipeline mínimo em Python
Esse snippet roda localmente se você tiver uma GPU com 8GB+ de VRAM. Mostra o esqueleto do que esses filtros fazem “por baixo do capô” — segmentação + inpainting + restauração.
# pip install diffusers transformers torch accelerate controlnet-aux
import torch
from PIL import Image
from diffusers import StableDiffusionXLInpaintPipeline, ControlNetModel
from controlnet_aux import MidasDetector

# 1) Carrega imagem original
img = Image.open("celebridade.jpg").convert("RGB").resize((1024, 1024))

# 2) Gera mapa de profundidade (ControlNet)
midas = MidasDetector.from_pretrained("lllyasviel/Annotators")
depth_map = midas(img)

# 3) Máscara do cabelo (use SAM ou um segmentador próprio)
#    Para o exemplo, vou supor que você já gerou uma máscara binária
mask = Image.open("mask_cabelo.png").convert("L").resize((1024, 1024))

# 4) Pipeline de inpainting com ControlNet
controlnet = ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0",
    torch_dtype=torch.float16
)
pipe = StableDiffusionXLInpaintPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    controlnet=controlnet,
    torch_dtype=torch.float16
).to("cuda")

# 5) Prompt descrevendo o corte alvo
prompt = "woman with short chanel haircut, sharp jaw-length bob, salon-quality, photo realistic"
negative = "blurry, deformed, plastic hair, changed face, extra fingers"

result = pipe(
    prompt=prompt,
    negative_prompt=negative,
    image=img,
    mask_image=mask,
    control_image=depth_map,
    num_inference_steps=30,
    guidance_scale=7.5,
).images[0]

result.save("resultado.png")
Troque o LoRA padrão por um fine-tune de “chanel haircut” do Civitai e você chega bem perto do que está viralizando. Para preservar o rosto, jogue o resultado no CodeFormer antes de publicar.
Erros Comuns (o que eu já quebrei em produção)
1) Pular a etapa de máscara. Tentar “dizer no prompt” o que é cabelo e o que não é. Funciona 1 em cada 10 vezes. Máscara binária confiável é obrigatória.
2) Usar resolução baixa. Cabelo tem textura fina. Abaixo de 1024×1024 o resultado fica empapado, principalmente em fotos noturnas ou com cabelo cacheado.
3) Confundir LoRA com checkpoint. LoRA é um adaptador pequeno (10–200MB) que ajusta o estilo. Checkpoint é o modelo base inteiro. Misturar dois checkpoints sem merge correto degrada tudo.
4) Ignorar o viés do dataset. A maioria dos modelos de cabelo foi treinada com fotos de mulheres brancas loiras. Em rostos negros ou asiáticos com cabelo crespo, o resultado frequentemente alisa ou muda a textura. Isso é bug vira feature vira problema ético.
5) Esquecer o pós-processamento. Sem face restoration, o rosto sai distorcido e ninguém confunde com foto real — bom para ética, ruim para viralizar. Você decide onde quer morar nesse espectro.
O lado sério: deepfakes, consentimento e E-E-A-T
Quando uma celebridade posta um vídeo gerado por IA sem aviso claro, o risco é duplo. Primeiro, seguidores desatentos saem convencidos de que a pessoa cortou o cabelo — o próprio Terra.com.br registrou comentários do tipo “Por que todo mundo está cortando o cabelo? O que eu perdi?”. Segundo, abre precedente para uso malicioso: mesma técnica, prompt diferente, rosto em contexto que a pessoa nunca autorizou.
Para quem está construindo produto nessa área, três práticas que eu adoto:
- Marca d’água visível e invisível. SynthID do Google, ou um C2PA manifesto na imagem final.
- Log de geração. Hash do prompt, modelo, seed, timestamp. Guarde. Serve para auditoria e para treinar melhor no próximo ciclo.
- Consentimento explícito quando a imagem é de terceiros. Isso não é juridicalês — é a única forma de não virar manchete daqui a seis meses.
Quando vale a pena construir vs. apenas consumir
Se você é dev e quer apenas brincar, os apps mobile entregam em 10 segundos o que leva um fim de semana para montar localmente. Se você quer:
- Oferecer isso como feature de um SaaS de edição;
- Controlar o modelo para evitar alisamento de cabelo crespo;
- Rodar em batch sem pagar por request;
- Treinar em um dataset proprietário de cortes específicos da sua marca;
…então a stack open source é inevitável. Hugging Face + Diffusers + um servidor com A10G ou L4 paga o investimento em 2–3 meses se o produto tração.
FAQ — o que um dev costuma perguntar
Quanto custa gerar uma imagem dessas em API?
Midjourney fica em torno de US$ 0,05 por imagem no plano Pro. DALL·E 3 cobra US$ 0,04 por imagem 1024². Rodando self-hosted com SDXL, o custo é essencialmente o da GPU — em AWS, uma g5.xlarge fica ~US$ 0,42/hora e gera centenas de imagens.
Qual o modelo open source mais indicado hoje para cabelo?
Para qualidade pura, Flux.1 dev. Para inpainting específico com máscara, SDXL + ControlNet ainda é o caminho mais documentado. Para preservar identidade, IP-Adapter + FaceID v2 é o estado da arte.
Preciso de GPU dedicada?
Para SDXL: mínimo 8GB VRAM (RTX 3060+, T4). Para Flux.1 dev: 24GB (RTX 4090, A10G, L4). Para testes com quantização de 4 bits, dá para rodar Flux em 12GB com perda aceitável.
Como evitar que o rosto mude junto com o cabelo?
Três caminhos que funcionaram pra mim: (1) usar IP-Adapter com referência da foto original; (2) rodar CodeFormer/GFPGAN só na região facial depois; (3) treinar um LoRA com o rosto da pessoa e usar weight baixo (0.3–0.5) na inferência.
É possível detectar que a imagem foi gerada por IA?
Sim, mas é uma corrida armamentista. Detectores como o do próprio Hive ou ferramentas como Illuminarty funcionam bem em modelos antigos. Em imagens geradas por Flux e Midjourney v6, a acurácia cai para 60–70%. Para garantia jurídica, melhor apostar em C2PA do que em detector puro.
No fim das contas, essa trend do cabelo curto com IA é o exemplo perfeito de como generative AI saiu do laboratório e virou produto de consumo em massa. Para nós, devs, é também um ótimo caso de estudo: pipeline modular, modelos open source maduros, ética em primeiro plano. Da próxima vez que alguém mostrar um “corte novo” no Instagram, você vai saber exatamente o que está rodando por trás — e se quiser, vai conseguir reproduzir.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.