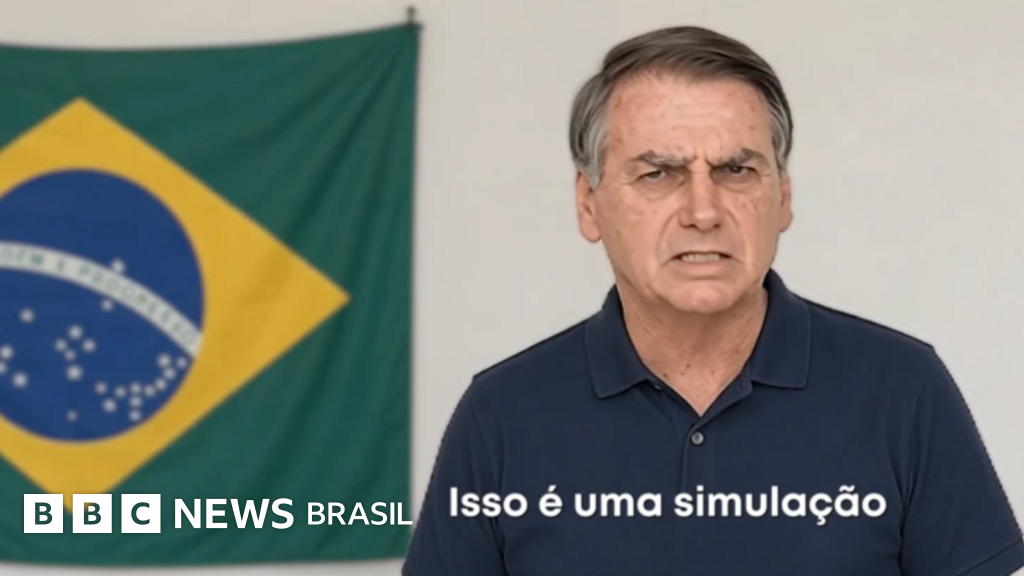
>Deepfakes já passaram do “uau, olha isso” para o “pô, não consigo saber se é real”. Em 2024, um vídeo do ex-presidente Jair Bolsonaro gerado por IA apareceu no lançamento da candidatura do Flávio Bolsonaro — caso reportado pela BBC News — e jogou luz em um problema que devolve o sono de quem trabalha com conteúdo digital. Não é mais teoria. Já tem impacto direto em eleições, processos trabalhistas e reputação de marcas.
Como programador que lida com sistemas de verificação e automação de mídia há anos, posso te dizer: a corrida entre quem gera e quem detecta está perdida por enquanto. Mas existem técnicas reais, bibliotecas funcionais e armadilhas conhecidas que separam quem detecta de quem chuta. É isso que vou destrinchar aqui.
Por que o caso Bolsonaro não é exceção — é o novo normal
O episódio envolvendo o vídeo de Bolsonaro não chamou atenção apenas pelo conteúdo político. Chamou porque era bom. Segundo a BBC, dois anos atrás essas imagens ainda saíam com dedos extras e mãos disformes. Hoje não. A evolução aconteceu por causa de três fatores técnicos convergentes:
- Diffusion models (Stable Diffusion, DALL·E 3, Midjourney v6) substituíram boa parte das GANs e produzem imagens com coerência espacial muito superior.
- Voice cloning em tempo real com 10 segundos de áudio já é possível (modelos como Tortoise-TTS, Coqui, ElevenLabs).
- Frame interpolation e lipsync automático (Wav2Lip, SadTalker) alinham a boca com o áudio gerado sem intervenção manual.
Isso significa que o ciclo de produção de um deepfake convincente caiu de semanas para minutos. O custo é quase zero. A detecção precisa ser tão automatizada quanto a geração — e aqui entra o trabalho de quem desenvolve.
Como deepfakes realmente funcionam por dentro
Para detectar bem, você precisa entender o que está procurando. A maioria dos deepfakes modernos usa uma de três arquiteturas:
1. Encoder-Decoder (a base clássica)
Um encoder extrai as features faciais da pessoa A. Um decoder, treinado para o rosto da pessoa B, reconstrói essas features no rosto B. Funciona bem em trocas de rosto, mas gera inconsistências nas bordas e na iluminação porque o decoder “aprendeu” como B se parece, não como B reage em cada situação.
2. GANs (Generative Adversarial Networks)
Uma rede gera imagens, outra tenta detectar falsificações. O gerador melhora até enganar o discriminador. Ainda é a base de muitas ferramentas de face-swap como DeepFaceLab e FaceSwap.
3. Diffusion Models (o estado da arte)
Modelos como Stable Diffusion começaram com ruído e aprenderam a remover o ruído progressivamente até chegar na imagem alvo. Produzem resultados fotorrealistas, mas deixam “impressões digitais” detectáveis no espectro de frequência — assunto que abordo no código abaixo.
O detalhe que pouca gente comenta: deepfakes raramente são perfeitos em todos os frames. Os modelos atuais ainda tropeçam em três pontos previsíveis — piscadas, reflexos nos olhos e sincronia labial em ângulos extremos. Saber onde procurar é metade do trabalho.
Na Prática: montando um detector de deepfake em Python
Não existe bala de prata, mas dá para combinar múltiplas técnicas em um pipeline razoavelmente eficaz. Vou te mostrar um exemplo funcional que roda localmente, sem GPU dedicada, usando bibliotecas abertas.
import cv2
import numpy as np
from PIL import Image, ImageChops
import face_recognition
import hashlib

def error_level_analysis(image_path, quality=90):
    """
    ELA: re-salva a imagem com qualidade reduzida e compara.
    Regiões manipuladas aparecem com brilho diferente.
    """
    original = Image.open(image_path).convert('RGB')
    temp_path = 'temp_resaved.jpg'
    original.save(temp_path, 'JPEG', quality=quality)
    resaved = Image.open(temp_path)

    ela = ImageChops.difference(original, resaved)
    extrema = ela.getextrema()
    max_diff = max([ex[1] for ex in extrema]) or 1

    ela = ela.point(lambda p: p * (255 / max_diff))
    return np.array(ela)

def eye_aspect_ratio(eye_landmarks):
    """EAR - taxa de aspecto do olho. Valor baixo = olho fechado."""
    v1 = np.linalg.norm(np.array(eye_landmarks[1]) - np.array(eye_landmarks[5]))
    v2 = np.linalg.norm(np.array(eye_landmarks[2]) - np.array(eye_landmarks[4]))
    h  = np.linalg.norm(np.array(eye_landmarks[0]) - np.array(eye_landmarks[3]))
    return (v1 + v2) / (2.0 * h)

def analyze_blinking(video_path):
    """Detecta anomalias no padrão de piscada."""
    cap = cv2.VideoCapture(video_path)
    ears = []
    frames_analyzed = 0

    while cap.isOpened() and frames_analyzed < 300:
        ret, frame = cap.read()
        if not ret:
            break

        rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
        landmarks = face_recognition.face_landmarks(rgb)

        if landmarks:
            eye = landmarks[0]['left_eye'] + landmarks[0]['right_eye']
            ears.append(eye_aspect_ratio(eye))
        frames_analyzed += 1

    cap.release()

    if not ears:
        return None

    return {
        'media_ear': np.mean(ears),
        'variacao': np.std(ears),
        'piscadas_detectadas': sum(1 for i in range(1, len(ears))
                                    if ears[i] < 0.2 and ears[i-1] >= 0.2)
    }

def detect_gan_artifacts(image_path):
    """Procura padrões de grade no espectro de frequência (assinatura de GAN)."""
    img = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)
    f = np.fft.fft2(img)
    fshift = np.fft.fftshift(f)
    magnitude = 20 * np.log(np.abs(fshift) + 1)

    # GANs costumam introduzir periodicidade simétrica
    h, w = magnitude.shape
    center = magnitude[h//2-50:h//2+50, w//2-50:w//2+50]

    return {
        'spectral_entropy': -np.sum(center * np.log(center + 1e-10)),
        'corner_energy': np.mean(magnitude[:20, :20]) +
                          np.mean(magnitude[-20:, -20:]),
        'suspect': np.mean(center) > 2 * np.mean(magnitude)
    }

def full_check(image_path):
    """Pipeline combinado: metadados + ELA + FFT."""
    with open(image_path, 'rb') as f:
        file_hash = hashlib.sha256(f.read()).hexdigest()

    return {
        'hash': file_hash,
        'ela_anomaly': np.mean(error_level_analysis(image_path)) > 30,
        'gan_signature': detect_gan_artifacts(image_path),
    }

# Uso:
resultado = full_check('foto_suspeita.jpg')
print(resultado)
Esse código não substitui um modelo treinado em milhares de amostras, mas já pega os sinais mais óbvios. Para produção, você combinaria com modelos pré-treinados como o efficientnet-b7 fine-tuned em datasets como FaceForensics++ ou usaria a API do Azure Content Safety.
Erros comuns que devs cometem ao tentar detectar deepfakes
Já vi muita gente perdendo tempo nessas armadilhas. Anota:
1. Confiar só no que o olho vê. Se você olhou e parece real, isso não é evidência técnica. É viés de confirmação. Sempre passe pelo pipeline automatizado.
2. Ignorar metadados EXIF. Imagens geradas por IA raramente têm EXIF consistente. Câmera, GPS, software ausente ou incoerente é um sinal forte — às vezes mais forte que a análise visual.
3. Usar dataset desatualizado para treinar. Modelo treinado em deepfakes de 2020 não detecta nada gerado pelo Stable Diffusion 3 ou Sora. O drift de domínio é brutal.
4. Esquecer da camada temporal. Vídeos deepfake quase sempre têm inconsistências entre frames consecutivos. Pixels “pulam” em regiões específicas. Análise frame-a-frame estático perde isso.
5. Achar que existe detector 100%. Não existe. O objetivo é aumentar o custo de criação do ataque. Se um atacante precisa gastar 10 horas para gerar algo que engana seu sistema, você venceu.
Ferramentas que valem seu tempo em 2026
- Sensity AI — API comercial, boa acurácia em vídeo, mas cara.
- Microsoft Video Authenticator — deu lugar ao Content Safety, mas a tecnologia ainda está no Azure.
- Deepware Scanner — gratuito para testes rápidos via app.
- FaceForensics++ — dataset e modelos para treinar o seu próprio detector.
- Hive Moderation API — bom custo-benefício para plataformas com alto volume.
Se você trabalha em plataforma que recebe upload de usuários — rede social, ferramenta de RH, sistema de KYC — implementar pelo menos uma camada de detecção virou requirement, não nice-to-have. A LGPD e a AI Act europeia já tratam conteúdo sintético não-rotulado como infração.
FAQ — Perguntas reais de quem está implementando
Como detectar deepfake de áudio especificamente?
Ferramentas como pyannote-audio e o detector da Resemble.ai identificam artefatos em ondas sonoras — frequências sobrepostas, ausência de ruído ambiente, padrões de respiração anômalos. Para verificação rápida, o Microsoft Speech Service tem um endpoint de verificação.
Vale a pena treinar meu próprio modelo?
Depende do volume. Se você processa menos de 10 mil mídias por mês, use API. Acima disso, treinar seu próprio modelo com FaceForensics++ e fine-tuning no seu domínio específico começa a compensar.
Qual a acurácia real dos detectores atuais?
Em condições controladas e dataset conhecido, 90–95%. No mundo real, com vídeos comprimidos do WhatsApp e novos modelos de geração, cai para 60–70%. É por isso que combinação de sinais vence detector único.
Detecção em tempo real é viável?
Em chamada de vídeo, sim — com latência aceitável usando modelos leves (MobileNet, EfficientNet-Lite). Em live stream, ainda é desafio porque o encoder do stream introduz compressão que “limpa” artefatos.
Como ficam as implicações legais?
O TSE brasileiro já tratou do caso Bolsonaro. A tendência é exigir rotulagem obrigatória de conteúdo sintético em períodos eleitorais. Para devs, isso significa pipeline que registra provenance do conteúdo — Coalition for Content Provenance and Authenticity (C2PA) é o padrão que está se consolidando.
Detectar deepfake virou problema de engenharia, não de discussão filosófica. Quem desenvolve precisa entender as técnicas de geração para não ficar três passos atrás. Se você chegou até aqui e quer aprofundar em alguma das técnicas que mostrei — FFT, ELA, modelos pré-treinados — comenta aí que faço um artigo focado.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.