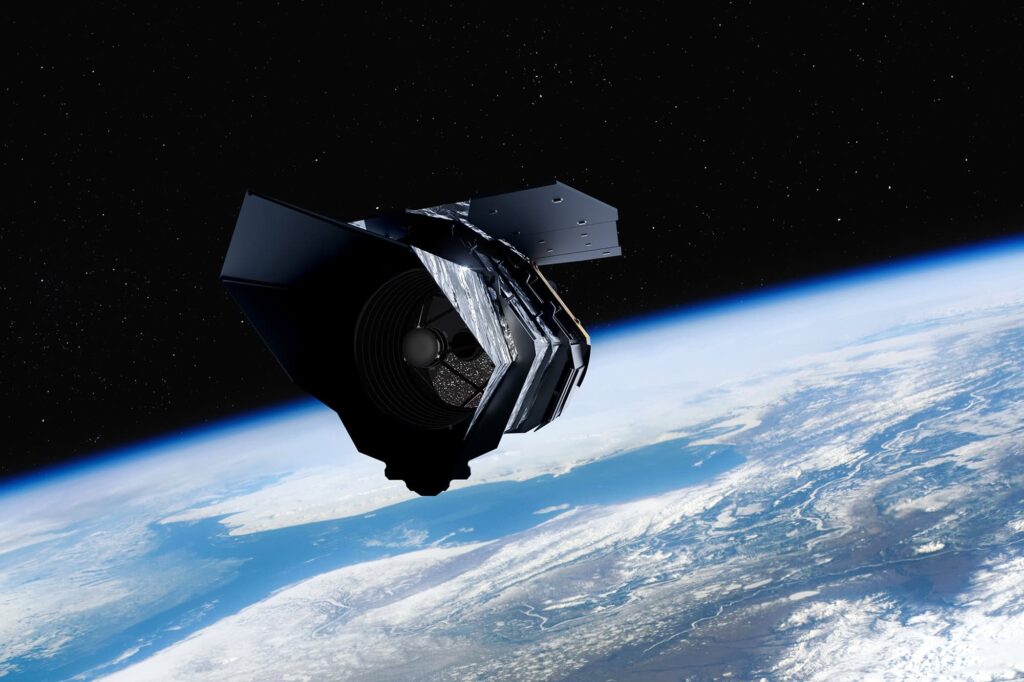
O telescópio que quase não existiu: o que está em jogo no lançamento do Nancy Grace Roman
Neste domingo (30), às 8h26 (horário de Brasília), a NASA coloca em órbita o Telescópio Espacial Nancy Grace Roman — uma missão infravermelha que o presidente dos EUA, Donald Trump, tentou cancelar mais de uma vez em propostas orçamentárias. Segundo o Olhardigital.com.br, o observatório decola a bordo de um Falcon Heavy, da SpaceX, direto do Centro Espacial Kennedy, na Flórida.
Mas o que me interessa, como dev e como alguém que trabalha com pipelines de dados pesados, não é o drama político. É o que vem depois: petabytes de dados infravermelhos chegando por ano, prontos pra serem mastigados por Python, NumPy e modelos de deep learning. E é isso que eu quero destrinchar aqui.
O que é o Roman e por que ele não é “mais um Hubble”
O Roman tem espelho primário de 2,4 metros — mesmo diâmetro do Hubble. O que muda brutalmente é o campo de visão: enquanto o Hubble enxerga cerca de 0,04 graus quadrados, o Wide Field Instrument (WFI) do Roman cobre ~0,28 graus quadrados por exposição. Traduzindo: uma única exposição do Roman cobre uma área do céu que o Hubble precisaria de ~100 exposições pra mapear.
O James Webb (JWST), pra completar a trinca, é o sniper: focado, profundo, caríssimo, mirando objetos distantes em altíssima resolução. O Roman é o mapeador. Ele foi projetado pra fazer surveys de grande área no infravermelho próximo, identificar candidatos que outros telescópios depois investigam em detalhe.
Três missões científicas centrais:
- Energia escura: medir a expansão do universo com precisão inédita via lentes gravitacionais fracas e supernovas tipo Ia.
- Exoplanetas: técnica de microlensing pra encontrar planetas errantes, planetas em zonas habitáveis e sistemas múltiplos.
- Infravermelho próximo (0,5–2,3 µm): enxergar através de poeira cósmica onde o visível não chega.
Por que devs deveriam prestar atenção em astronomia infravermelha
Toda vez que um telescópio novo entra em operação, a NASA abre os dados pro público via Mikulski Archive for Space Telescopes (MAST). Isso não é filantropia — é requisito legal pra manter financiamento. E os dados do Roman são distribuídos em FITS files acessíveis por API REST.
Na minha experiência com data engineering, poucos domínios empurram tanto o limite de petabyte-scale processing quanto astronomia observacional. O Roman vai gerar volumes massivos de dados brutos que precisam passar por:
- Calibração (dark, flat, bias frames)
- Astrometria (WCS solving — ligar pixel a coordenadas celestes)
- Fotometria (contagem de fótons por fonte)
- Co-addição de exposições
- Detecção de fontes (Source Extractor, photutils, ou CNNs modernas)
Se você trabalha com Spark, Dask ou Ray, esse é um playground razoável. Tem grupos rodando pipelines do LSST (Legacy Survey of Space and Time, predecessor conceitual) em Kubernetes na AWS com S3 como data lake. O mesmo padrão arquitetural serve pro Roman.
Na Prática: lendo dados simulados do Roman com Python
O time da NASA/STScI já disponibiliza simulações de imagens do WFI pra desenvolvedores testarem pipelines antes do lançamento. Segue um snippet funcional que abre um FITS multi-extension, extrai WCS, normaliza com ZScale e plota:
# pip install astropy matplotlib numpy
from astropy.io import fits
from astropy.wcs import WCS
from astropy.visualization import ZScaleInterval, ImageNormalize
import matplotlib.pyplot as plt
import numpy as np

# Arquivos do Roman WFI são FITS multi-extension
# Simulações reais: https://roman-docs.stsci.edu/simulations
fits_path = "roman_wfi_sim.fits"

with fits.open(fits_path) as hdul:
 # Estrutura típica: SCI (1), ERR (2), DQ (3), WHT (4)
 hdul.info()

 science = hdul["SCI"].data.astype(np.float32)
 error = hdul["ERR"].data
 wcs = WCS(hdul["SCI"].header)

# ZScale é o stretch padrão usado pelo ds9 em astronomia
norm = ImageNormalize(science, interval=ZScaleInterval())

fig = plt.figure(figsize=(12, 12))
ax = fig.add_subplot(111, projection=wcs)
im = ax.imshow(science, norm=norm, cmap="magma")

ax.set_xlabel("Right Ascension")
ax.set_ylabel("Declination")
ax.coords.grid(True, color="white", alpha=0.3)
plt.colorbar(im, ax=ax, label="e⁻/s")
plt.title("Roman WFI — Simulated Field")
plt.savefig("roman_preview.png", dpi=150, bbox_inches="tight")
Cuidado com armadilha clássica: a chave "SCI" é case-sensitive e assume que o FITS segue o convencionado do Roman Calibration Pipeline. Se você baixar dados de pipelines antigos (pre-2022), a estrutura pode ser diferente — extensão numerada em vez de nomeada. Valide sempre com hdul.info() antes de acessar.
Comparativo honesto: Hubble vs JWST vs Roman
| Característica | Hubble | James Webb | Roman |
|---|---|---|---|
| Espelho primário | 2,4 m | 6,5 m (segmentado) | 2,4 m |
| Comprimento de onda | Visível / UV / NIR | IR médio (0,6–28 µm) | IR próximo (0,5–2,3 µm) |
| Campo de visão | ~0,04 sq deg | ~0,003 sq deg | ~0,28 sq deg |
| Órbita | LEO (547 km) | L2 (1,5M km) | L2 (1,5M km) |
| Custo estimado | US$ 2,5 bi | US$ 10 bi | US$ 3,5 bi |
| Foco da missão | Imaging geral | Universo profundo, alto z | Survey + energia escura |
O ponto crítico pra quem trabalha com dados: o JWST gera volumes menores por exposição, mas baixíssima taxa de survey. O Roman, por ser wide-field, vai catalogar ordens de magnitude mais fontes por unidade de tempo. Se você pretende treinar modelos de detecção de objetos astronômicos, o Roman vira o dataset padrão da década.
Erros Comuns que devs cometem ao trabalhar com dados astronômicos
- Confundir counts com fluxo físico. FITS guardam contagens brutas de fótons por pixel. Pra comparar com outros surveys em outras faixas, você precisa converter pra AB magnitudes ou Jansky. Não pule essa etapa — seu cross-match vai dar lixo.
- Ignorar o WCS. World Coordinate System é o que liga (x, y) a (RA, Dec). Sem ele, qualquer tentativa de cruzar com catálogos externos quebra silenciosamente.
- Esticar o histograma errado. Imagens astronômicas têm distribuição log-normal. Use
ZScaleIntervalouAsinhStretch, nunca linear. Vai parecer bonito, mas você perde ~95% da informação nas caudas. - Assumir céu = fundo constante. Há gradientes de luz zodiacal, contaminação da Via Láctea, vignetting do detector. Tudo isso exige modelagem de background antes de detectar fontes.
- Não versionar os dados brutos. Pipelines científicos re-processam arquivos o tempo todo. Sem DVC ou Git LFS, perde reprodutibilidade — e o reviewer do paper vai te odiar.
- Rodar CNN em RGB convertido. Imagens FITS são single-channel com informação de erro por pixel. Converter pra RGB 8-bit antes de mandar pra rede é a forma mais rápida de jogar fora a precisão do sensor.
Machine learning e o futuro dos surveys
O que me empolga mais é o que vem depois do lançamento. O time do Roman já publicou benchmarks usando CNNs pra detectar exoplanetas via microlensing em dados sintéticos. Transformers de visão (ViT) estão substituindo o Source Extractor clássico em performance, especialmente em campos crowded.
Se você quer brincar agora mesmo: a organização spacetelescope no GitHub mantém o romancal (calibration pipeline), o Grizli (redução de dados) e o WebbPSF (simulação de PSF). Tudo open source, tudo Python, tudo pronto pra você clonar e quebrar à vontade.
FAQ — Perguntas que devs realmente fazem
1. O Nancy Grace Roman substitui o Hubble?
Não. São missões complementares. O Hubble faz alta resolução em campo pequeno; o Roman faz survey de grande área no infravermelho. Ambos vão operar em paralelo até pelo menos 2030.
2. Os dados do Roman são abertos pra uso comercial?
Sim. Dados públicos da NASA são domínio público (US government work). Você pode usar em produtos, papers, fine-tuning de modelos, qualquer coisa — sem royalties e sem pedir permissão.
3. Qual a latência entre captura e disponibilidade no MAST?
Tipicamente 24–72 horas para dados Level 1 (calibrados). Level 2 (catálogos derivados) depende do survey específico. O Roman promete latência menor que o Hubble, mirando releases quase em tempo real.
4. Dá pra treinar um LLM com papers do Roman?
Tecnicamente sim, mas o corpus ainda é pequeno. O melhor agora é usar o NASA Astrophysics Data System (ADS), que indexa ~5 milhões de papers. Pra fine-tuning em exoplanetologia, dá pra montar dataset razoável em poucos meses.
5. Por que Falcon Heavy e não SLS ou outro foguete?
O Roman pesa cerca de 4.100 kg e vai pra L2. É exatamente o perfil do Falcon Heavy. Reutilizar os boosters laterais (a SpaceX recupera os dois) economiza dezenas de milhões por missão. Custo final reportado pela NASA: ~250 milhões só em launch services.
Por que acompanhar esse lançamento mesmo sem ser astrônomo
Toda missão grande da NASA ensina duas coisas pra quem trabalha com tecnologia: (1) como escalar pipelines em volumes absurdos de dados não estruturados, e (2) como construir sistemas tolerantes a falha onde refazer a missão não é opção. O software de voo do Roman é congelado antes do lançamento — patch em órbita é raríssimo e arriscadíssimo.
Esse mesmo mindset aparece em edge computing em locais remotos, sistemas embarcados médicos ou qualquer cenário onde “atualizar depois” não existe. Estude como o STScI faz — é aula gratuita de robustez de software crítico.
Vou acompanhar o lançamento no domingo. Se aparecer novidade relevante (anomalias, adiamento, dados preliminares nos primeiros dias), eu volto aqui pra atualizar com análise técnica.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.