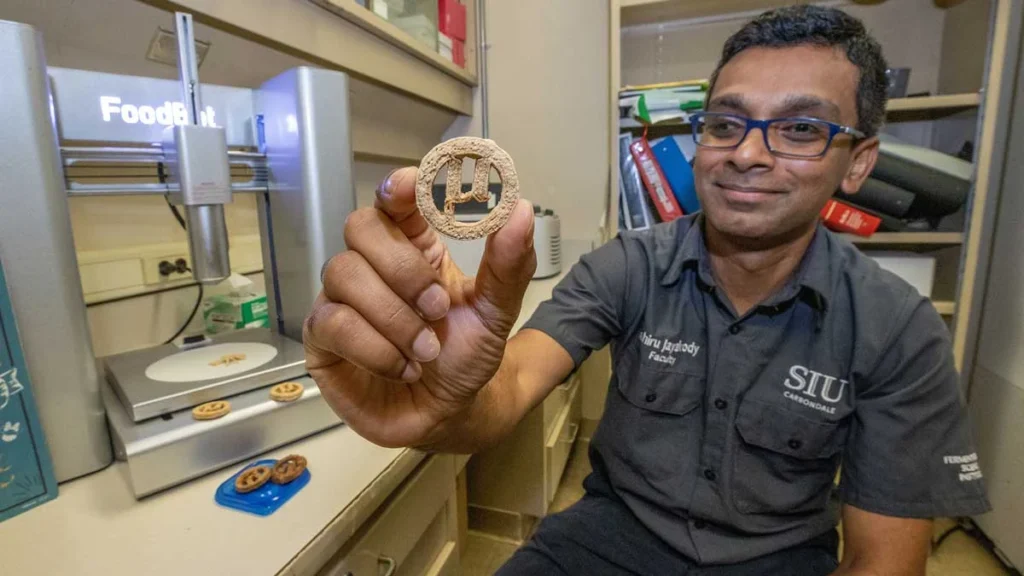
Segundo o Sapo.pt, investigadores estão a transformar garrafas de plástico (PET) em “bolachas” ricas em proteínas, vitaminas e até com aroma a baunilha. E a sacada aqui vai além do curioso: é sobre fechar o ciclo de carbono e produzir comida no lugar certo, com logística viável — inclusive em missões espaciais de longa duração. Eu adoro este tipo de problema porque cruza química, bioengenharia e engenharia de produção… e, para devs, também cruza com otimização, pipelines e validação de processos.
µBites: quando reciclagem encontra bioquímica (e produção sob restrições)
O projeto µBites nasceu na Southern Illinois University Carbondale (SIU), no contexto do Deep Space Food Challenge da NASA. A ideia não é “reciclar por reciclar”. É usar o que já existe (plástico PET) como fonte de carbono e construir moléculas com a ajuda de microrganismos — um raciocínio bem semelhante ao de “fazer software a partir de artefatos”, só que aqui os artefatos são moléculas.
Na apresentação recente (ACS Fall 2026, Chicago), a linha geral é esta: o PET é um polímero muito comum em garrafas. Ele carrega carbono em abundância, e carbono é essencial para alimentos. Se você conseguir desmontar as moléculas do plástico e recuperar o carbono em uma forma “assimilável”, certos microrganismos conseguem usar isso para produzir compostos necessários para nutrição.
O que o Sapo.pt não diz, mas importa: “desmontar” não é trivial
Desmontar PET envolve química de degradação (tipicamente hidrólise catalisada, dependendo do processo). O ponto crítico para viabilizar comida não é só produzir qualquer produto, mas produzir um “feedstock” com composição consistente e sem contaminantes que estraguem o sabor, a segurança alimentar ou a eficiência biológica.
Em projetos reais de engenharia, esse detalhe vira o divisor de águas entre “funciona em laboratório” e “vira cadeia de produção”. Mesmo em IA e software, a gente sabe: dados inconsistentes derrubam modelos. Em bioprocessos, o equivalente é o feedstock inconsistente e impurezas imprevisíveis.
Por que isso é relevante para software (sim, software): pipelines de validação e consistência
Quando vejo algo como µBites, penso imediatamente em três coisas que devs reconhecem:
- Pipeline de transformação: PET → quebra química → carbono “recuperável” → fermentação/microrganismos → biomassa + formulação.
- Controle de qualidade: checar pureza, contaminantes, perfil nutricional e estabilidade do produto final.
- Repetibilidade: garantir que o lote A seja comparável ao lote B.
Na prática, isso vira um “sistema distribuído” de medições e decisões. Se você não medir bem (e medir com consistência), você não consegue escalar. E é aqui que muitos times tropeçam: acham que o avanço é só “achar o método biológico” e ignoram instrumentação, rastreabilidade e padrões de aceitação.
Comparações com alternativas reais: reciclar é fácil; alimentar é difícil
Vamos comparar com rotas que existem ou são discutidas em reciclagem e bioeconomia:
1) Reciclagem mecânica (mais comum, menos “food-grade”)
Reciclar mecanicamente PET normalmente entrega material para reuso em embalagens, não para ingestão. Para comida, você enfrenta limites de contaminantes, degradação por calor e dificuldade de garantir segurança alimentar.
2) Reciclagem química para monômeros (potencialmente mais controlável)
Reciclagem química tenta recuperar componentes mais “limpos”. Em teoria, isso aproxima da exigência de segurança — mas ainda precisa provar qualidade e viabilidade em escala.
3) Rotas biológicas (a ponte para transformar carbono em alimento)
O µBites entra exatamente aqui: usar microrganismos como conversores. O ganho é que a biologia consegue construir estruturas complexas a partir de insumos simples. O preço é que você precisa controlar condições (pH, temperatura, oxigênio, taxa de alimentação) para manter rendimento e perfil nutricional.
O que torna isso “diferente” é a meta: não é só converter carbono; é produzir uma “bolacha” com características sensoriais e nutricionais que façam sentido para humanos.
Armadilhas e erros comuns (o que eu evitaria, tanto em laboratório quanto em código)
Erros comuns em bioengenharia (traduzidos para a linguagem de dev)
- Assumir que “rendimento” resolve tudo: você pode ter alto rendimento, mas perfil nutricional errado ou excesso de impurezas.
- Ignorar variância entre lotes: variação do PET (origem, contaminantes, aditivos) muda completamente o resultado.
- Subestimar o “tempo de ciclagem”: em bioprocessos, a janela experimental custa caro. Sem automação e monitoramento, você se perde.
Erros comuns em dev quando o problema parece “só dados”
- Ficar sem métricas: “achamos que está bom” não escala. Você precisa de métricas de qualidade, limites e alertas.
- Não tratar rastreabilidade: sem um “lote” auditável, você não consegue corrigir regressões.
- Validar só no fim: checar tudo apenas no produto final é caro. O correto é validação em estágios (gates), como em CI/CD.
Na Prática: como eu modelaria esse processo como um “sistema” com gates e logs
Vou propor um exemplo bem concreto, no estilo de engenharia de processos. Mesmo que não seja o “algoritmo científico” real, o desenho de software para operar algo assim segue padrões que eu aplicaria numa plataforma de produção/qualidade.
- Definir “insumos” e suas especificações (feedstock de PET pós-degradação):
- composição alvo (frações de carbono/padrões)
- limites de contaminantes
- umidade/viscosidade
- Instrumentar e coletar sinais:
- parâmetros do reator (pH, temperatura, tempo)
- indicadores do cultivo microbiano (concentrações, taxas)
- checagens de estabilidade do produto
- Implementar “gates” de qualidade:
- se passar no gate 1, libera para etapa 2
- se falhar, reprocessa/descarta com regras claras
- Armazenar tudo com rastreabilidade por lote:
- config do processo
- resultados das medições
- versionamento do “receituário” (parâmetros e fórmulas)
- Validar o produto final com critérios múltiplos:
- perfil nutricional (proteína, vitaminas)
- segurança (contaminantes)
- aceitação sensorial (quando aplicável)
Se você fizer isso como software, você reduz o risco clássico: “funciona hoje, quebra amanhã”. E é exatamente esse tipo de confiabilidade que uma missão espacial exigiria.
Um exemplo de código funcional (validação com gates por lote)
Em um sistema real, eu começaria com regras explícitas. Exemplo em Python (puro, sem dependências) para validar limites e decidir o fluxo:
from dataclasses import dataclass, asdict

@dataclass
class FeedstockSpec:
    carbon_recover_percent_min: float
    contaminant_ppm_max: float
    moisture_percent_max: float

def validate_feedstock(measurements: dict, spec: FeedstockSpec) -> list[str]:
    errors = []

    carbon = measurements.get("carbon_recover_percent")
    contaminant = measurements.get("contaminant_ppm")
    moisture = measurements.get("moisture_percent")

    if carbon is None or contaminant is None or moisture is None:
        return ["measurements_missing_required_fields"]

    if carbon < spec.carbon_recover_percent_min:
        errors.append(f"carbon_recover_too_low: {carbon}")

    if contaminant > spec.contaminant_ppm_max:
        errors.append(f"contaminant_too_high: {contaminant}")

    if moisture > spec.moisture_percent_max:
        errors.append(f"moisture_too_high: {moisture}")

    return errors

def decide_gate(errors: list[str]) -> str:
    if not errors:
        return "GATE_PASSED"
    # Em produção eu separaria falhas reprocessáveis vs fatais.
    return "GATE_FAILED"

# Exemplo de uso:
spec = FeedstockSpec(
    carbon_recover_percent_min=35.0,
    contaminant_ppm_max=80.0,
    moisture_percent_max=12.0
)

measurements = {
    "carbon_recover_percent": 41.2,
    "contaminant_ppm": 62.0,
    "moisture_percent": 10.3
}

errors = validate_feedstock(measurements, spec)
gate = decide_gate(errors)

print("spec:", asdict(spec))
print("measurements:", measurements)
print("errors:", errors)
print("gate:", gate)
O “porquê” dessa decisão técnica: ao invés de inferir qualidade de forma subjetiva, você transforma critérios em regras executáveis. Isso permite auditoria, testes automatizados e evolução do processo sem perder controle.
Implicações práticas para quem programa (e para quem lidera produto)
Mesmo que você não vá tocar no reator, você pode aplicar o mesmo raciocínio em qualquer projeto:
- Automação de validação: gates curtos e claros diminuem retrabalho.
- Rastreabilidade por lote: você quer reproduzir o que aconteceu quando algo quebra.
- Monitoramento orientado a decisão: métricas sem ação são só dashboards.
- Versionamento do “recipe”: parâmetros e fórmulas mudam. Sem versionar, você perde a história.
E isso vale tanto para pipelines de dados quanto para MLOps. O paralelo com o µBites é forte: no fundo, você está sempre convertendo “insumo incerto” em “resultado aceito”.
FAQ
O que exatamente “nasceu de uma garrafa de plástico” significa no projeto µBites?
Segundo o Sapo.pt, o PET (o plástico comum de garrafas) é degradado para recuperar carbono em forma utilizável. A partir disso, microrganismos produzem compostos que entram na formulação do alimento.
Por que esse tipo de comida faz sentido para missões espaciais?
Porque a missão precisa de fontes sustentáveis e com logística reduzida. Se você consegue produzir alimento a partir de materiais abundantes (ou reciclados), diminui dependência de suprimentos da Terra.
Quais são as principais dificuldades técnicas além de “transformar PET em comida”?
Controle de contaminantes, consistência entre lotes, rendimento real por etapa e validação de segurança e nutrição. Sem isso, a tecnologia não sai do laboratório.
Isso substitui reciclagem tradicional de PET?
Não é necessariamente substituição. Reciclagem tradicional atende bem aplicações como materiais de embalagem. A rota do µBites mira o nível de segurança e funcionalidade exigidos por alimento.
Como devs podem contribuir mesmo sem ser da área química?
Construindo sistemas de instrumentação, rastreabilidade, pipelines de controle de qualidade, automação de experimentos e validação (no estilo CI/CD com gates e auditoria por lote).
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.